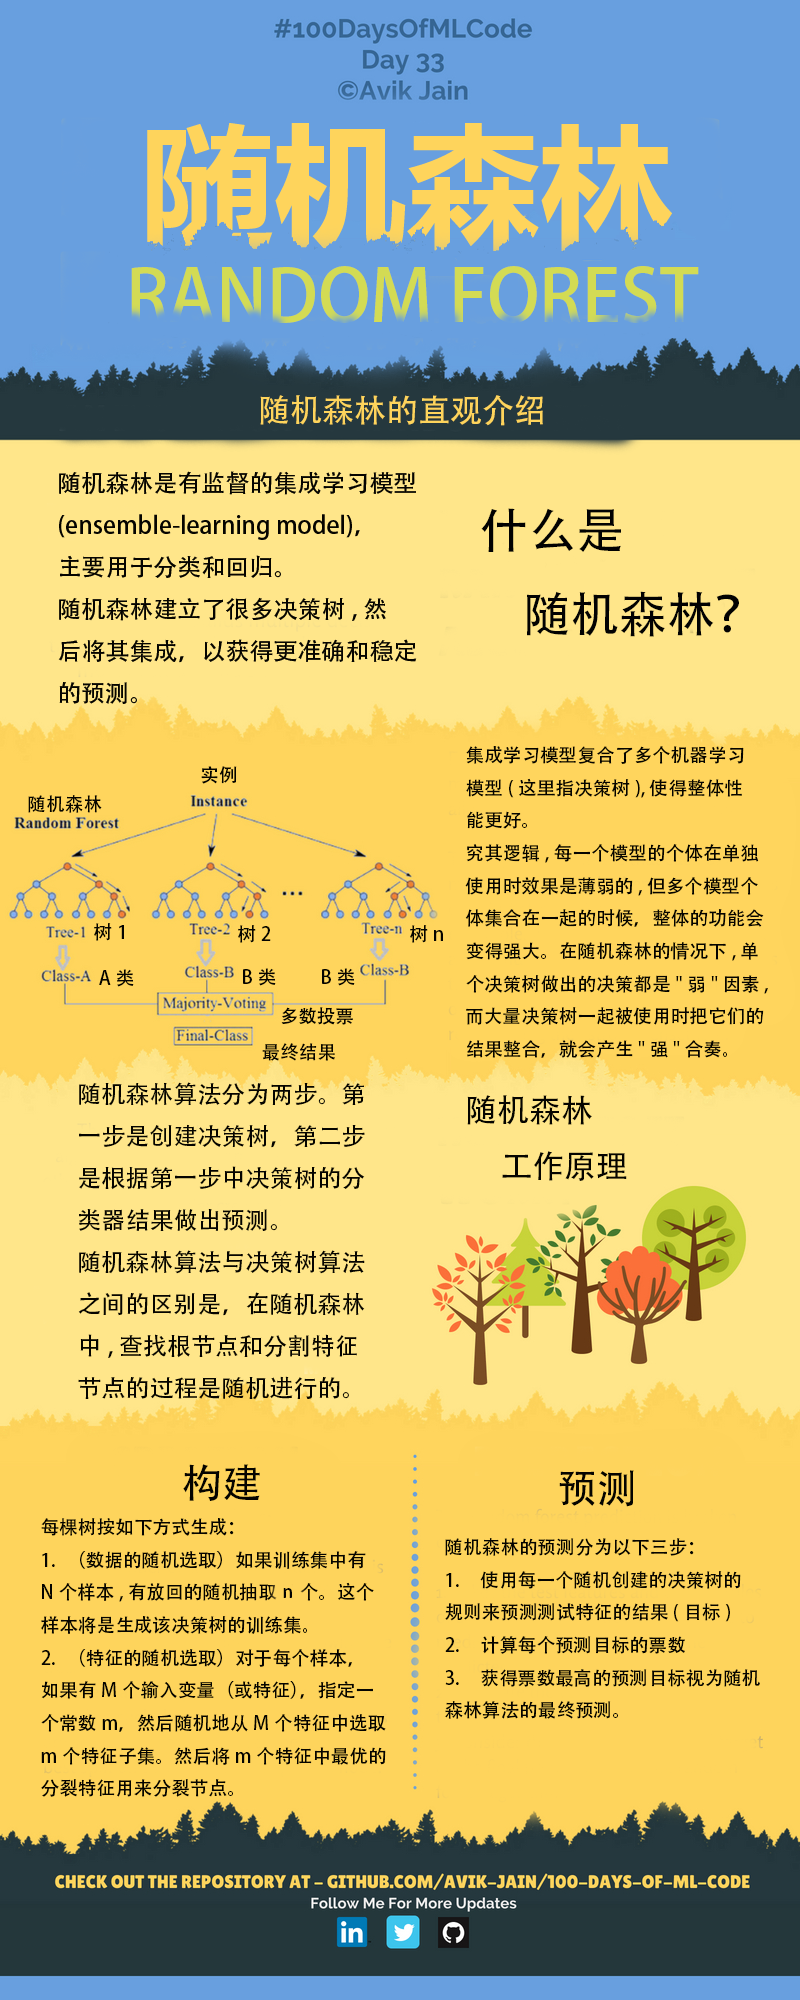
随机森林(决策树)模型
数据集
导入库
1 | import numpy as np |
导入数据集
1 | dataset = pd.read_csv('../datasets/Social_Network_Ads.csv') |
将数据集拆分成训练集和测试集
1 | from sklearn.model_selection import train_test_split |
特征缩放
1 | from sklearn.preprocessing import StandardScaler |
调试训练集的随机森林
1 | from sklearn.ensemble import RandomForestClassifier |
预测测试集结果
1 | y_pred = classifier.predict(X_test) |
生成混淆矩阵,以及准确率、召回率分析结果
1 | from sklearn.metrics import confusion_matrix, classification_report |
打印混淆矩阵 cm 以及分析结果(准确率,召回率,F1值)cr:1
2
3
4
5
6
7
8matrix:
[[63 5]
[ 3 29]]
report:
precision recall f1-score support
0 0.95 0.93 0.94 68
1 0.85 0.91 0.88 32
avg / total 0.92 0.92 0.92 100
结果可视化
将训练集结果可视化
1 | from matplotlib.colors import ListedColormap |
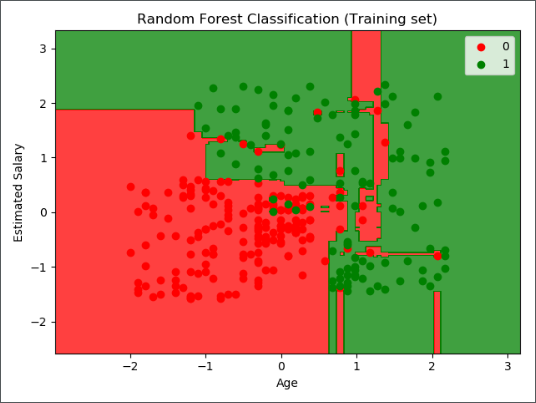
将测试集结果可视化
1 | from matplotlib.colors import ListedColormap |
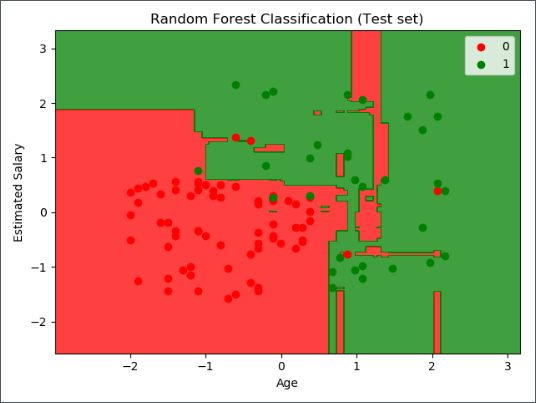
随机森林(回归树)模型
待补充
调参 ★
在 scikit-learn 中,Random Forest(以下简称RF)的分类类是 RandomForestClassifier,回归类是 RandomForestRegressor。
RF 需要调参的参数也包括两部分,第一部分是 Bagging 框架的参数,第二部分是 CART 决策树的参数。下面我们就对这些参数做一个介绍。
RF 框架参数
首先我们关注于 RF 的 Bagging 框架的参数。这里可以和 GBDT 对比来学习。GBDT 的框架参数比较多,重要的有最大迭代器个数,步长和子采样比例,调参起来比较费力。但是 RF 则比较简单,这是因为 bagging 框架里的各个弱学习器之间是没有依赖关系的,这减小的调参的难度。换句话说,达到同样的调参效果,RF 调参时间要比 GBDT 少一些。
下面我来看看 RF 重要的 Bagging 框架的参数,由于 RandomForestClassifier 和 RandomForestRegressor 参数绝大部分相同,这里会将它们一起讲,不同点会指出。
- n_estimators:也就是弱学习器的最大迭代次数,或者说最大的弱学习器的个数。一般来说 n_estimators 太小,容易欠拟合,n_estimators 太大,计算量会太大,并且 n_estimators 到一定的数量后,再增大 n_estimators 获得的模型提升会很小,所以一般选择一个适中的数值。默认是
100。 - oob_score:即是否采用袋外样本来评估模型的好坏。默认识
False。个人推荐设置为True,因为袋外分数反应了一个模型拟合后的泛化能力。 - criterion: 即 CART 树做划分时对特征的评价标准。分类模型和回归模型的损失函数是不一样的。分类 RF 对应的 CART 分类树默认是基尼系数
gini,另一个可选择的标准是信息增益。回归 RF 对应的 CART 回归树默认是均方差mse,另一个可以选择的标准是绝对值差mae。一般来说选择默认的标准就已经很好的。
从上面可以看出, RF 重要的框架参数比较少,主要需要关注的是 n_estimators,即 RF 最大的决策树个数。
RF 决策树参数
下面我们再来看 RF 的决策树参数:
- RF 划分时考虑的最大特征数 max_features:
可以使用很多种类型的值,默认是auto,意味着划分时最多考虑 $\sqrt {N}$ 个特征;如果是log2意味着划分时最多考虑 $log_2N$ 个特征;如果是sqrt或者auto意味着划分时最多考虑$\sqrt {N}$ 个特征。如果是整数,代表考虑的特征绝对数。如果是浮点数,代表考虑特征百分比,即考虑(百分比 x $N$)取整后的特征数。其中 $N$ 为样本总特征数。一般我们用默认的auto就可以了,如果特征数非常多,我们可以灵活使用刚才描述的其他取值来控制划分时考虑的最大特征数,以控制决策树的生成时间。 - 决策树最大深度 max_depth:
默认可以不输入,如果不输入的话,决策树在建立子树的时候不会限制子树的深度。一般来说,数据少或者特征少的时候可以不管这个值。如果模型样本量多,特征也多的情况下,推荐限制这个最大深度,具体的取值取决于数据的分布。常用的可以取值10-100之间。 - 内部节点再划分所需最小样本数 min_samples_split:
这个值限制了子树继续划分的条件,如果某节点的样本数少于 min_samples_split,则不会继续再尝试选择最优特征来进行划分。默认是2,如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。 - 叶子节点最少样本数 min_samples_leaf:
这个值限制了叶子节点最少的样本数,如果某叶子节点数目小于样本数,则会和兄弟节点一起被剪枝。 默认是1,可以输入最少的样本数的整数,或者最少样本数占样本总数的百分比。如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。 - 叶子节点最小的样本权重 min_weight_fraction_leaf:
这个值限制了叶子节点所有样本权重和的最小值,如果小于这个值,则会和兄弟节点一起被剪枝。默认是0,就是不考虑权重问题。一般来说,如果我们有较多样本有缺失值,或者分类树样本的分布类别偏差很大,就会引入样本权重,这时我们就要注意这个值了。 - 最大叶子节点数 max_leaf_nodes:
通过限制最大叶子节点数,可以防止过拟合,默认是None,即不限制最大的叶子节点数。如果加了限制,算法会建立在最大叶子节点数内最优的决策树。如果特征不多,可以不考虑这个值,但是如果特征分成多的话,可以加以限制,具体的值可以通过交叉验证得到。 - 节点划分最小不纯度 min_impurity_split:
这个值限制了决策树的增长,如果某节点的不纯度(基于基尼系数,均方差)小于这个阈值,则该节点不再生成子节点。即为叶子节点 。一般不推荐改动,默认值1e-7。
上面决策树参数中最重要的包括最大特征数 max_features, 最大深度 max_depth, 内部节点再划分所需最小样本数 min_samples_split 和叶子节点最少样本数 min_samples_leaf。
调参实例
我们使用社交网络数据集为例,利用 sklearn.grid_search 中的 GridSearchCV 类进行网格搜索最佳参数,现有两种调参思路。
- 串行调参思路:调整一个或几个参数,固定其他参数,得到所调整参数的最优。重复以上步骤,使得每个参数都得打最优
- 并行调参思路:参数同时进行调整,不过计算量比较大,但是一次性能够找到最好的参数
载入需要的库
1 | from sklearn.ensemble import RandomForestClassifier |
调整参数 n_estimators
1 | param_test1 = {'n_estimators': list(range(10, 71, 10))} |
输出结果:1
2
3
4
5
6
7
8
9[mean: 0.93815, std: 0.03733, params: {'n_estimators': 10},
mean: 0.93743, std: 0.03838, params: {'n_estimators': 20},
mean: 0.94205, std: 0.03770, params: {'n_estimators': 30},
mean: 0.94091, std: 0.03771, params: {'n_estimators': 40},
mean: 0.94160, std: 0.03842, params: {'n_estimators': 50},
mean: 0.94112, std: 0.03840, params: {'n_estimators': 60},
mean: 0.94042, std: 0.03757, params: {'n_estimators': 70}]
{'n_estimators': 30}
0.9420531338494724
调整参数 max_depth
得到了最佳的弱学习器迭代次数为 30 ,我们将相应参数进行修改,接着我们对决策树最大深度 max_depth 和内部节点再划分所需最小样本数 min_samples_split 进行网格搜索。1
2
3
4
5
6
7
8
9
10param_test2 = {'max_depth': list(range(3, 12, 1)), 'min_samples_split': list(range(5, 101, 5))}
classifier = RandomForestClassifier(n_estimators=30,
min_samples_leaf=2,
criterion='entropy',
oob_score=True,
random_state=0)
gsearch2 = GridSearchCV(estimator=classifier, param_grid=param_test2, scoring='roc_auc', iid=False, cv=5)
gsearch2.fit(X_train, y_train)
print(gsearch2.best_params_)
print(gsearch2.best_score_)
输出结果:1
2{'max_depth': 7, 'min_samples_split': 20}
0.9426982890941702
调整参数 min_samples_split 和 min_samples_split
对于内部节点再划分所需最小样本数 min_samples_split ,我们暂时不能一起定下来,因为这个还和决策树其他的参数存在关联。下面我们再对内部节点再划分所需最小样本数 min_samples_split 和叶子节点最少样本数 min_samples_leaf 一起调参。1
2
3
4
5
6
7
8
9
10param_test3 = {'min_samples_split': list(range(5, 51, 5)), 'min_samples_leaf': list(range(5, 51, 5))}
classifier = RandomForestClassifier(n_estimators=30,
max_depth=7,
criterion='entropy',
oob_score=True,
random_state=0)
gsearch3 = GridSearchCV(estimator=classifier, param_grid=param_test3, scoring='roc_auc', iid=False, cv=5)
gsearch3.fit(X_train, y_train)
print(gsearch3.best_params_)
print(gsearch3.best_score_)
输出结果:1
2{'min_samples_leaf': 5, 'min_samples_split': 30}
0.9419350440517489
至此相关参数已调整完毕,不过这种串行调优方式并不能一次性找到最好的解。我们可以将参数可选的值一次性的导入网格,使得所有参数调优同步进行,但是这样会降低程序运行的效率,可能需要大量的计算资源。如果算力强大,还是值得一试的。
同步调参
同步进行调参时,我本地电脑的程序根本无法运行,无奈把代码放到学校的服务器上用两个 GPU 同时跑的程序。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from sklearn.ensemble import RandomForestClassifier
from sklearn.grid_search import GridSearchCV
# from sklearn.model_selection import GridSearchCV
param_test = {'n_estimators': list(range(10, 71, 5)),
'max_depth': list(range(3, 12, 1)),
'min_samples_split': list(range(2, 51, 2)),
'min_samples_leaf': list(range(2, 51, 2))}
classifier = RandomForestClassifier(
# n_estimators=30,
# min_samples_split=20,
# min_samples_leaf=2,
# max_depth=7,
criterion='entropy',
oob_score=True,
random_state=0)
gsearch = GridSearchCV(estimator=classifier, param_grid=param_test, scoring='roc_auc', iid=False, cv=5, n_jobs=-1)
gsearch.fit(X_train, y_train)
print(gsearch.best_params_)
print(gsearch.best_score_)
输出结果1
2{'max_depth': 4, 'min_samples_leaf': 16, 'min_samples_split': 34, 'n_estimators': 55}
0.9471759933430413
对比了一下同步调参和之前的调参结果,相差很大有没有,当参数组合起来进行同时调整的结果会跟一个一个调整参数有很大的出入。